AI-агент для spec-driven разработки: как мы встроили ревью по требованиям в GitLab и Mattermost

Оценка задач в аутсорс-разработке часто расходится с реальностью: на бумаге «добавить кнопку», а в коде обнаруживаются роли, статусы, старый API и скрытые бизнес-правила. Мы спроектировали AI-агента, который работает до оценки и в командных инструментах (Mattermost и GitLab): собирает требования в спецификации, ведёт их через Merge Request (MR) и проверяет код на соответствие согласованной спецификации. В статье разберём архитектуру, конвейер из четырёх скиллов и риски.
Статус проекта. Стенд (GitLab, Mattermost и OpenClaw) поднят и работает локально, но в реальный процесс команды пока не встроен. Пилот на живых проектах впереди. Если ищете статью «мы внедрили, и вот метрики», это не она. Если интересно, как спроектировать AI-агента для командного, а не сольного spec-driven процесса и что у него внутри, добро пожаловать.
Почему оценка задач в аутсорс-разработке расходится с реальностью
В аутсорс- и аутстафф-разработке есть знакомый момент. Клиент приносит задачу, команда быстро смотрит требования, лид или аналитик прикидывает объём, PM согласует часы, и всё выглядит управляемо. На бумаге это «добавить кнопку», «чуть поправить поиск», «сделать форму на пару дней».
А потом разработчик открывает код.
Выясняется, что кнопка зависит от ролей, статусов, трёх сервисов и старого API. Поиск тянет за собой контракт, индексы, обработку ошибок и состояние интерфейса. Простая форма меняет жизненный цикл сущности и требует вопросов к бизнесу, которые никто не успел задать до оценки.
Это формат «приключение на пять минут». На входе выглядит как короткая прогулка, а через пару часов ты стоишь по колено в легаси и пытаешься понять, кто вообще владелец этого бизнес-правила.
Хуже всего, что снаружи это выглядит как «разработчик не уложился». На деле команда оценивала не ту задачу, которую потом пришлось делать. Часы согласованы, ожидания PM и клиента зафиксированы, а код сообщает: «за два дня это не делается».
Дальше вариантов немного:
- команда доделывает бесплатно;
- начинается болезненное пересогласование;
- разработчик тащит переработку на себе и чувствует вину за оценку, которую не мог дать вовремя.
Это не просто вопрос точности планирования. Здесь теряются деньги, репутация и нормальное состояние людей.
Две причины неточной оценки
Скрытые технические сложности не ищут специально. Зависимости в коде, архитектурные ограничения и неочевидные бизнес-правила требуют отдельного анализа, а не беглого прочтения тикета.
Контекст решений теряется. Часть обсуждений происходит устно или в переписке и не доходит до разработчика в структурированном виде. Он реконструирует логику по обрывкам сообщений.
Решение, на мой взгляд, не в ещё одном чате, который красиво перескажет тикет. Нужна жёсткая связка: требования становятся спецификацией в репозитории, проходят ревью и не могут тихо разъехаться с кодом. Это фиксирует инфраструктура. Как устроена связка, опишу ниже.
Чем наш подход отличается от github-spec-kit и Kiro
На рынке уже есть инструменты для spec-driven development: от github-spec-kit до агентов вроде Kiro. Идея «сначала пишем спецификацию, потом код» не новая. Когда я формулировала задачу для себя, первая мысль была: «мы же переизобретаем то, что уже придумано».
Большинство таких фреймворков рассчитаны на одного разработчика, который работает с агентом в IDE один на один. Он сам формулирует требования агенту и сам получает код. Это решает проблему «агент написал код не подумав», но не нашу. У нас разрыв возникает раньше, на этапе оценки, и шире, между несколькими людьми: клиент, аналитик, лид, PM, разработчик.
Если встроить агента только в IDE конкретного разработчика, он появится в процессе слишком поздно. К моменту, когда разработчик открыл редактор, часы уже согласованы, ожидания клиента зафиксированы, и если оценка была неточной, это уже случилось.
Поэтому мы спроектировали агента так, чтобы он работал до этапа оценки и в командных инструментах, которыми и так пользуется вся команда: Mattermost для коммуникации и GitLab для ведения спецификаций.
Роль агента: второе мнение, а не замена человека
На текущем этапе агент не оценивает трудозатраты вместо команды. До оценки его задача — разобрать требования, подсветить зависимости, ограничения и открытые вопросы. Человек оценивает уже не короткое описание из тикета, а зафиксированный объём работ и риски.
В пилоте мы планируем вести две оценки параллельно, человеческую и агентную, и сравнивать обе с фактическими трудозатратами. Зафиксированная спецификация даст общий контекст для сравнения и позволит улучшать точность обеих оценок.
Почему «ИИ сделал плохо» не разбирается без спецификации
Разработчик, который только начинает работать с ИИ, часто говорит: «ИИ сделал плохо», «я сам быстрее», и на этом разговор заканчивается. Объективной причины обычно нет. Непонятно, какой контекст подали на вход: обрывок тикета, устное «сделай как в соседнем модуле» или промпт без ограничений.
Без артефакта, по которому шла генерация, нечего разбирать. Неясно, где ошиблась модель, где не хватило данных, а где человек некорректно сформулировал задачу. Когда спецификация, интервью и решения лежат в репозитории рядом с кодом, можно посмотреть конкретный вход, понять, что пошло не так, и улучшать процесс итеративно, а не спорить на ощущениях.
Архитектура AI-агента: четыре скилла от kickoff до code-review
Внутри спецификации мы опираемся на привычную для DDD и Clean Architecture логику артефактов: сценарии, доменные агрегаты, бизнес-правила, критерии приёмки.
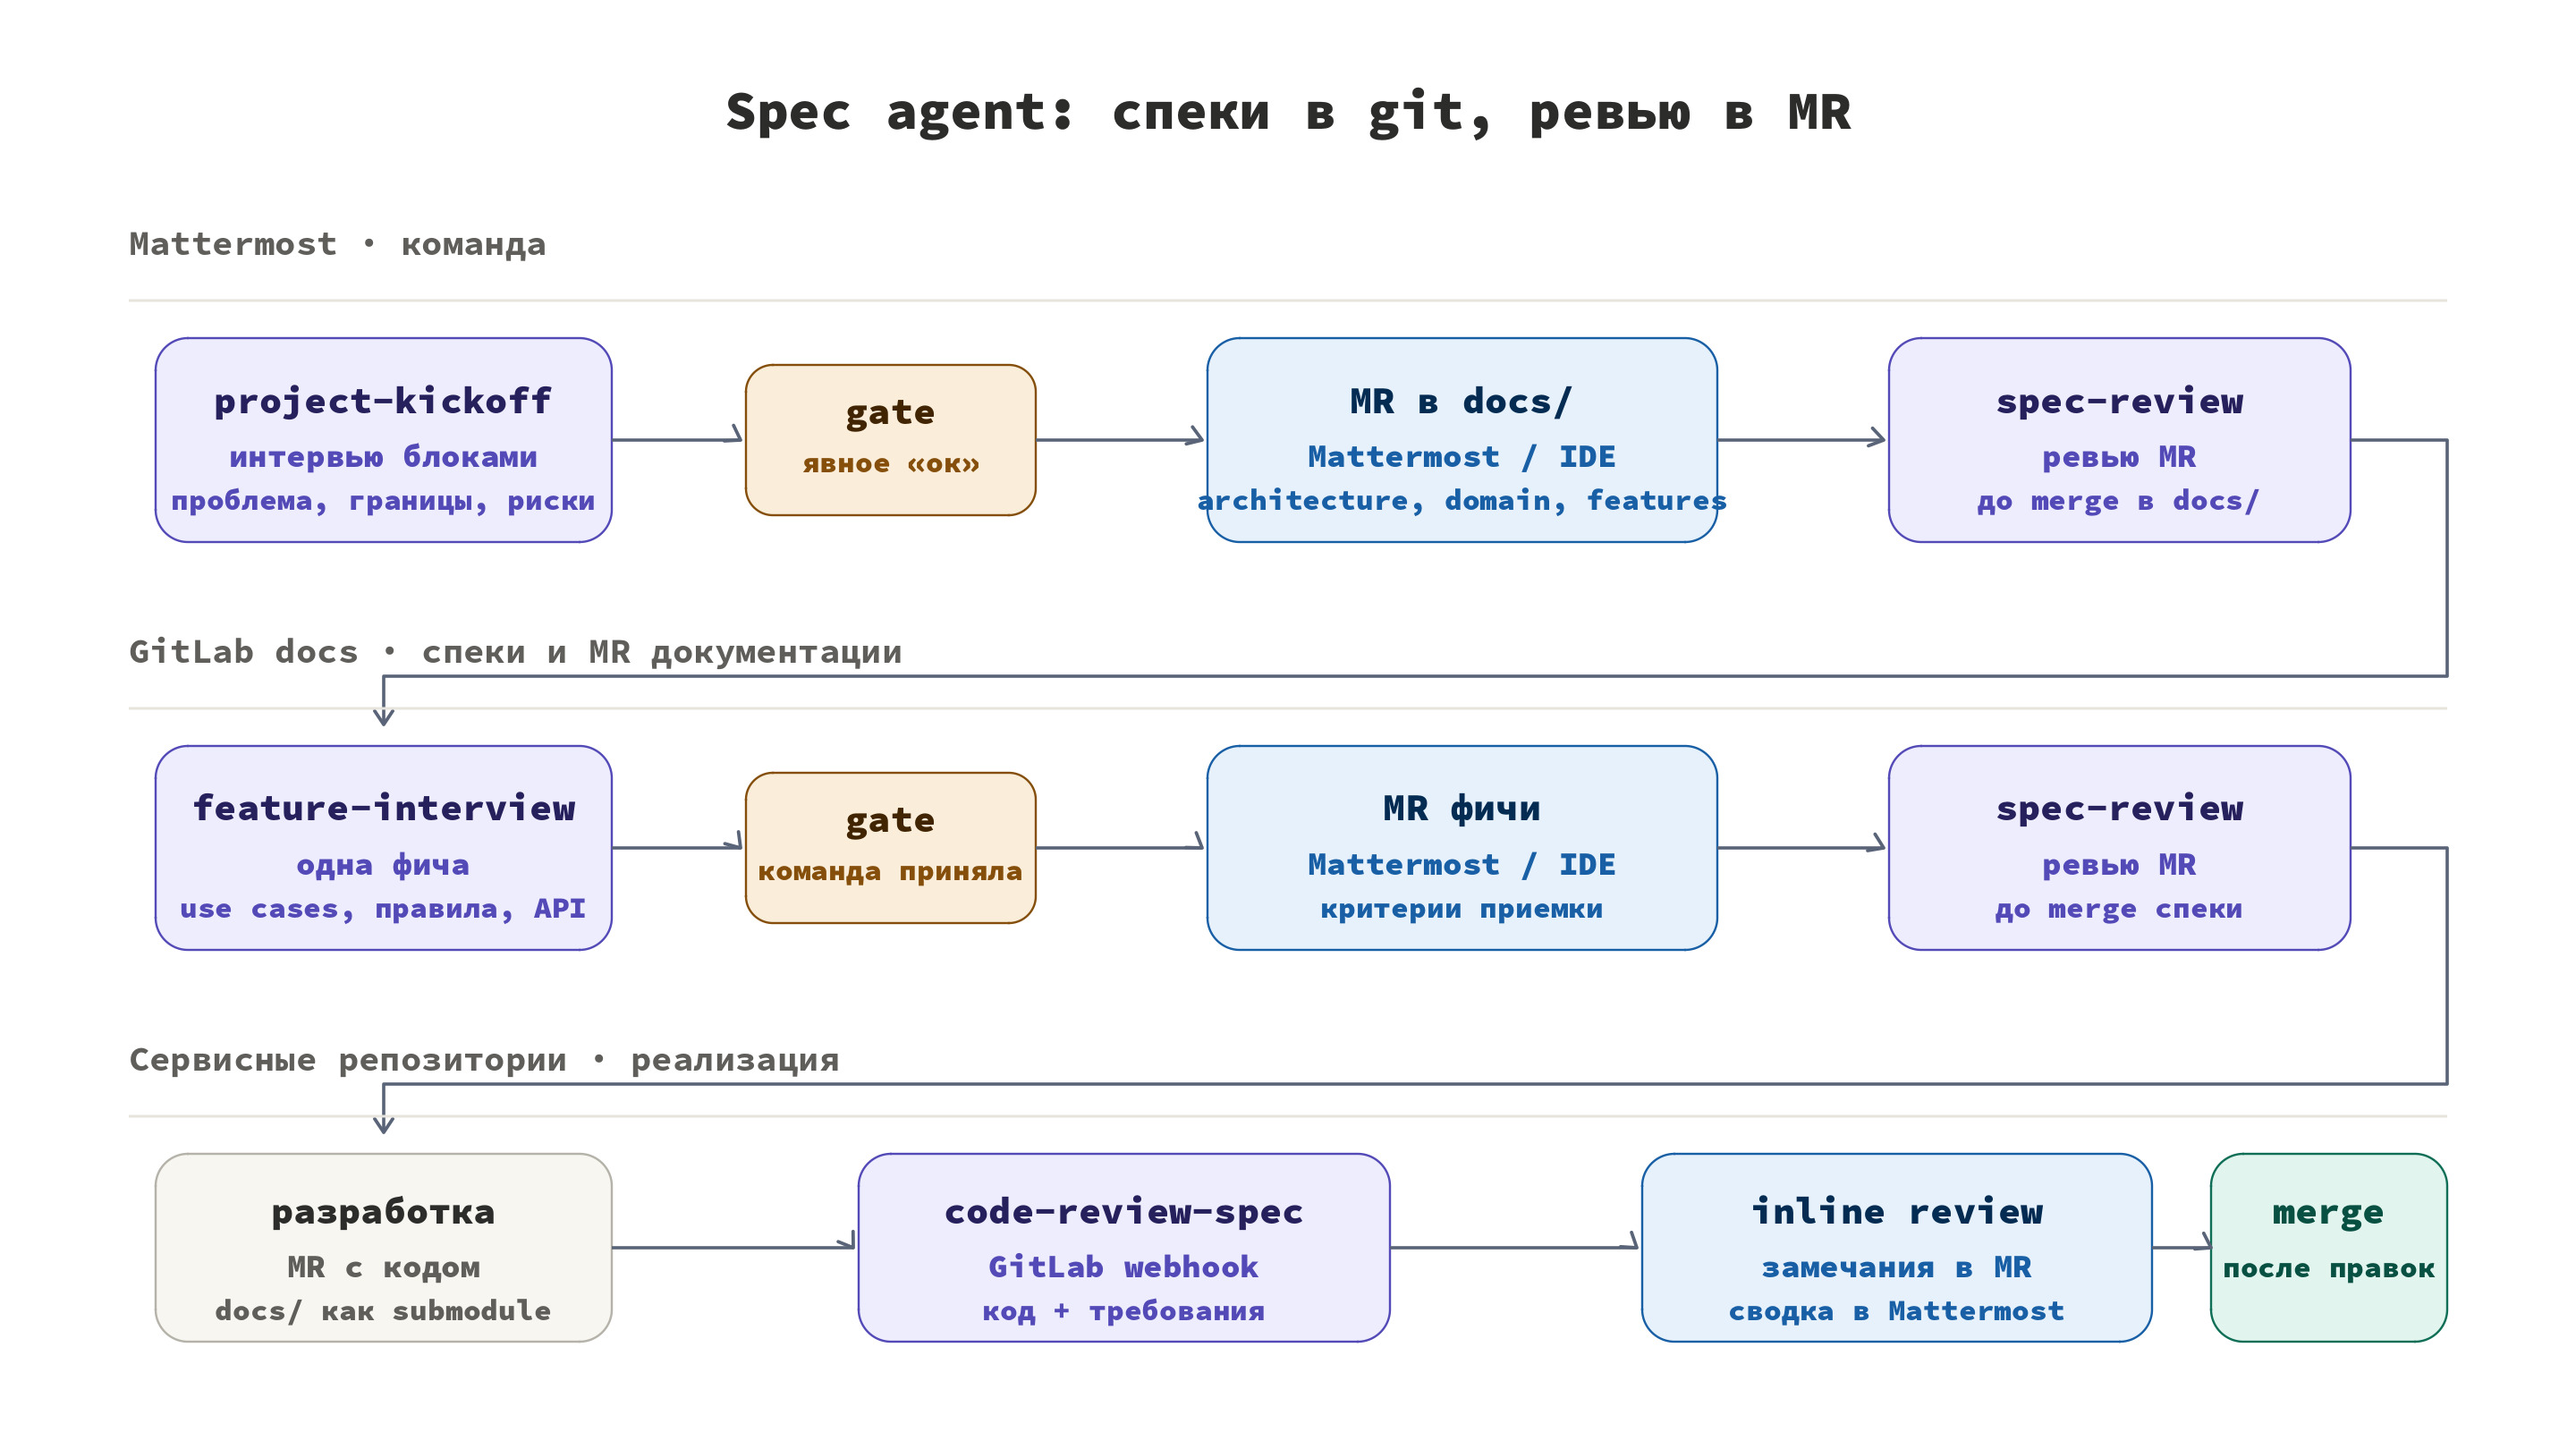
Вместо одного универсального промпта мы разбили процесс на четыре скилла. Скилл здесь — отдельный модуль агента со своим промптом и своей задачей. Каждый скилл отвечает за свой этап и передаёт результат следующему:
project-kickoff → feature-interview → spec-review → code-review-spec
| Скилл | Когда используется | Что делает |
|---|---|---|
| project-kickoff | Старт проекта или крупного модуля | Читает сырые материалы клиента, отдельно выделяя реальную проблему и предложенное решение. Проводит интервью с командой блоками (проблема и цель → пользователи → границы системы → ограничения → риски). Собирает архитектурный обзор и черновики фич |
| feature-interview | Детализация одной фичи | Задаёт по одному вопросу и предлагает варианты решения. Делит описание на сценарии и доменные модели, чтобы «контрагент» в одной фиче не превращался в «партнёра» в другой. Последнее слово всегда за человеком |
| spec-review | Ревью MR со спецификацией перед слиянием в docs/ | Ловит расплывчатые критерии приёмки: не «поиск работает», а «поиск по заголовку возвращает результат за ≤500 мс при запросе от 3 символов». Проверяет связи с docs/domain/ и оставляет замечания прямо в MR |
| code-review-spec | Открытие MR в сервисном репозитории (через вебхук GitLab) | Сверяет код не только со стилем и паттернами, но и с тем, что команда зафиксировала в спецификации |
Принцип явного подтверждения
Агент не переходит к следующему блоку без явного подтверждения команды. После интервью и spec-review он не создаёт MR без финального «ок». Так в ревью попадает то, что люди действительно обсудили, а не документация, которую агент додумал сам.
Mattermost остаётся местом интервью и согласования. Результат фиксируется и проходит ревью в GitLab, с обсуждением и историей изменений.
Как это выглядит: от интервью в Mattermost до MR в GitLab
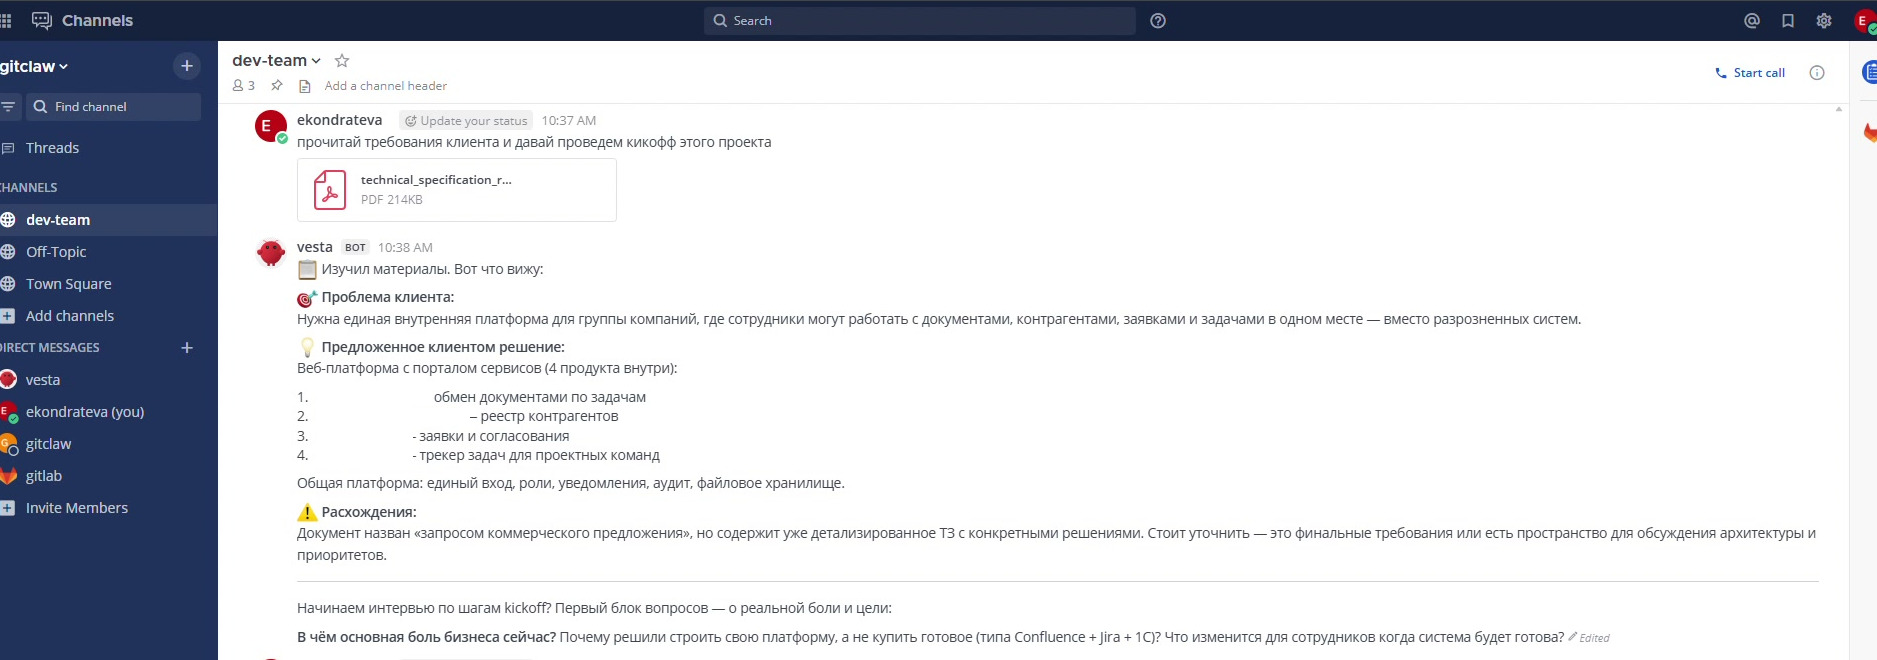
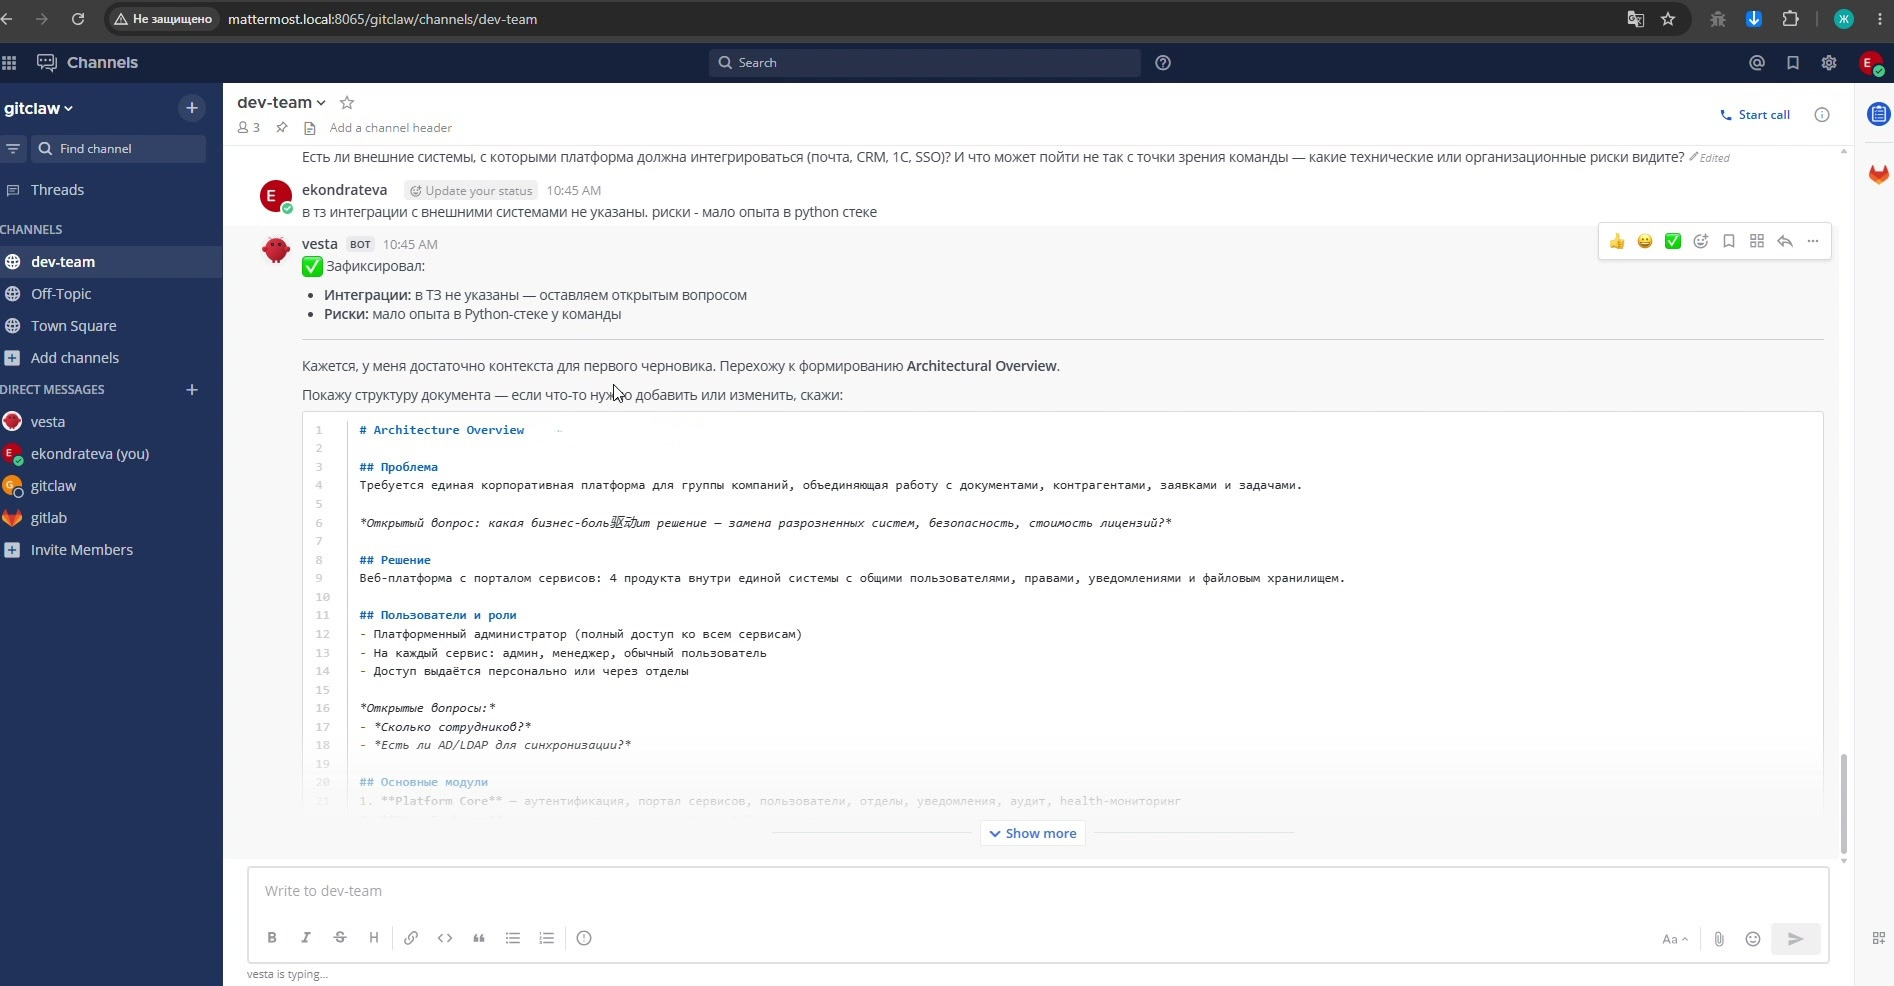
Ниже показано, как выглядят project-kickoff и spec-review стартовой документации на экране. Названия модулей на скриншотах скрыты, чтобы избежать совпадения с реальными системами.
- Загрузка ТЗ клиента. Пользователь прикрепляет PDF с требованиями. Агент не копирует документ слепо, а разделяет бизнес-проблему, предложенное решение и расхождения. Например, документ оформлен как коммерческое предложение, но внутри уже детальное ТЗ. Это повод уточнить у заказчика, финальные ли это требования.
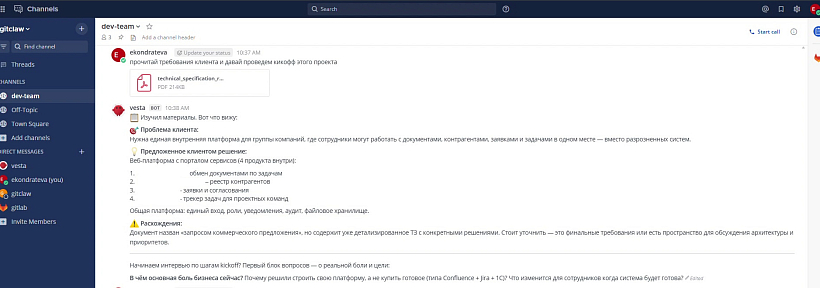
Чат с AI-агентом: загруженный PDF с ТЗ клиента и разбор бизнес-проблемы отдельно от решения - Kickoff-интервью в Mattermost. В канале dev-team после каждого ответа бот проекта (я назвала его Веста) фиксирует решение, а неизвестное выносит в открытые вопросы вместо того, чтобы додумывать требования. Лишний символ в тексте на скриншоте даёт представление о том, локальная модель какого семейства использовалась 😅
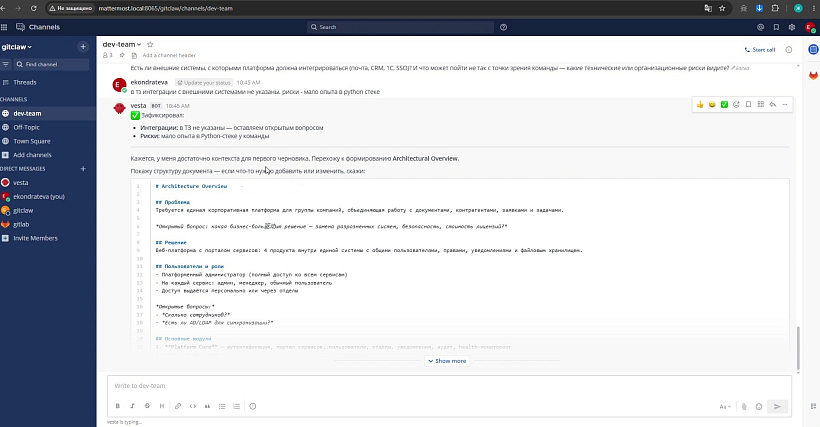
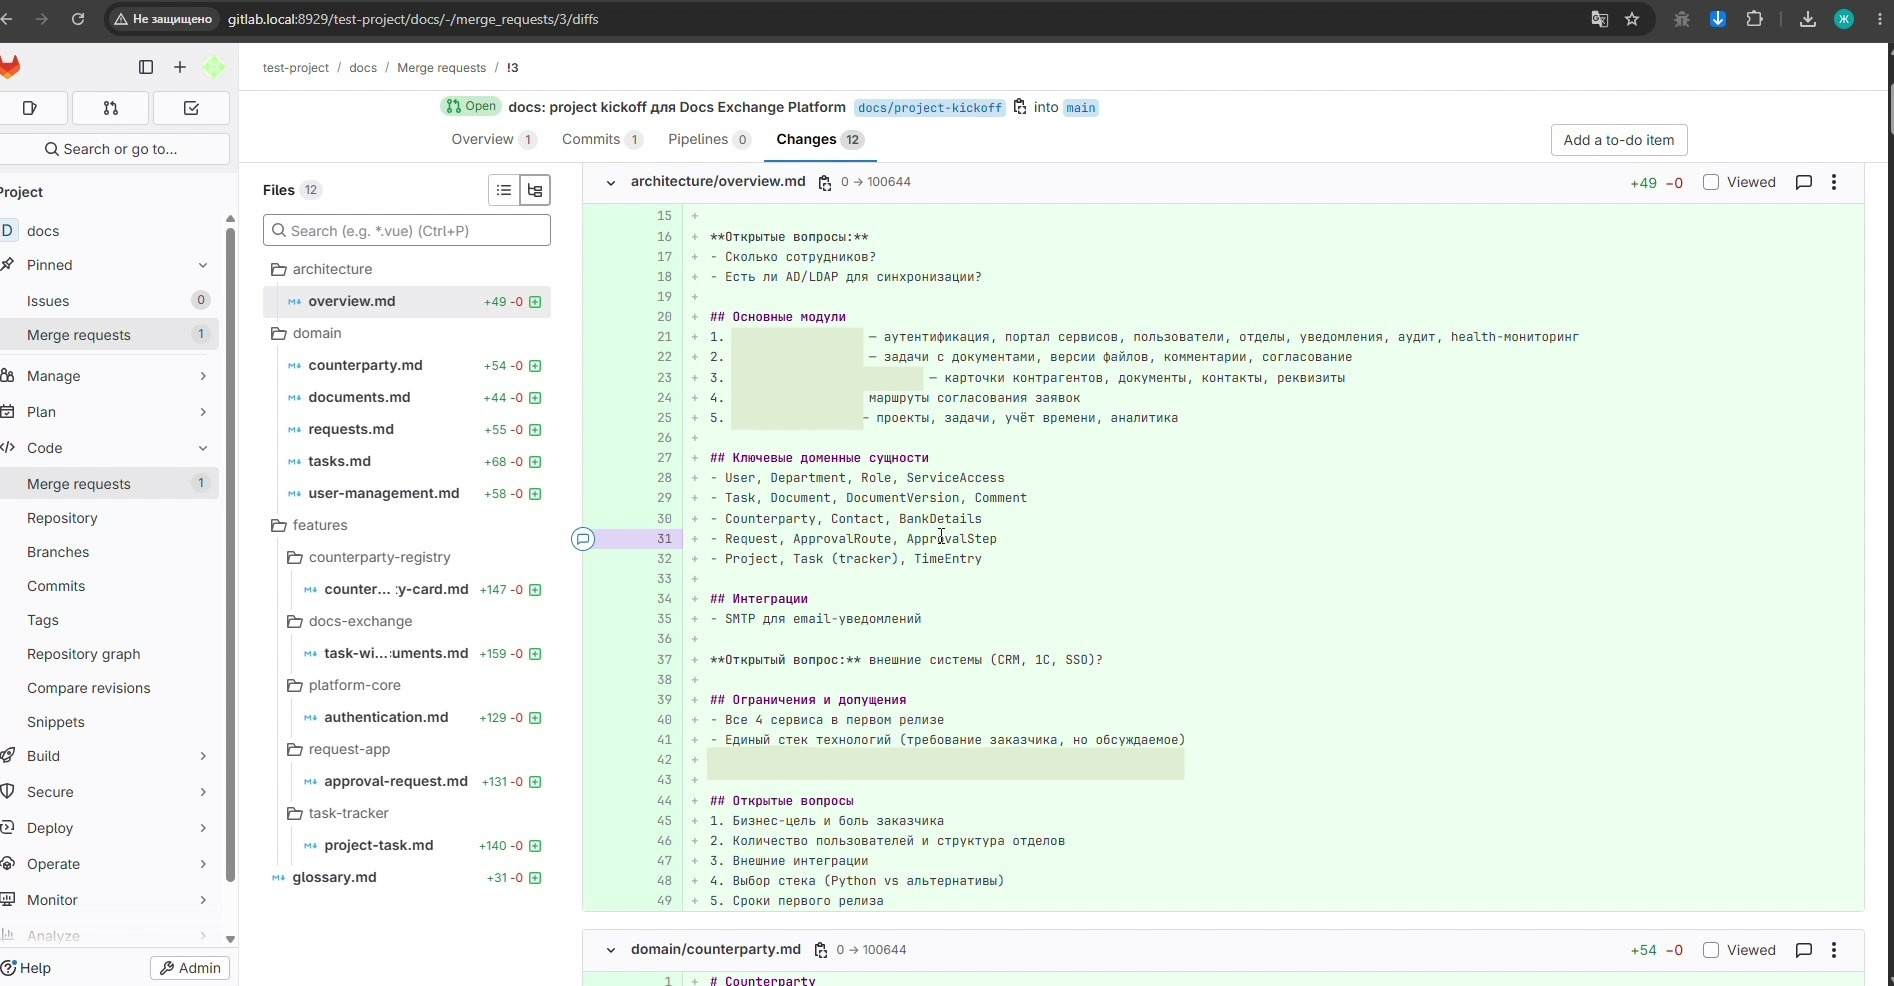
Kickoff-интервью AI-агента с командой в Mattermost: блоки вопросов и зафиксированные решения - MR со стартовой документацией. После согласования агент создаёт ветку и открывает MR: 12 файлов в
architecture/,domain/,features/иglossary.md. Это архитектурный обзор, доменные модели, черновики фич с открытыми вопросами и глоссарий.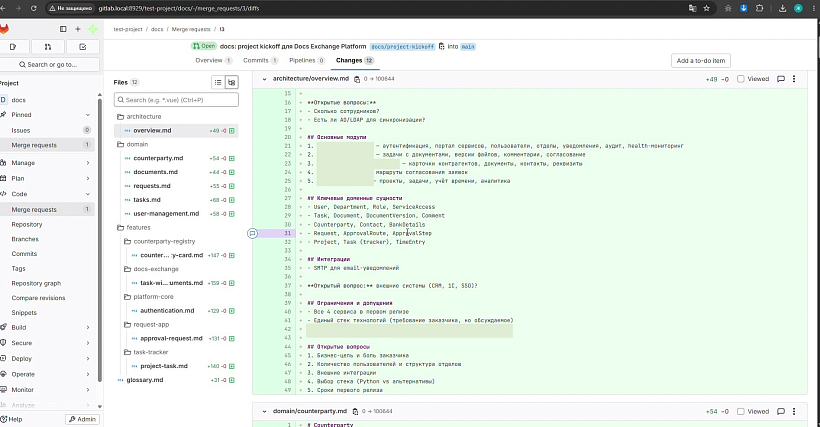
Merge Request в GitLab со стартовой документацией: файлы в architecture, domain, features и glossary Важный нюанс:
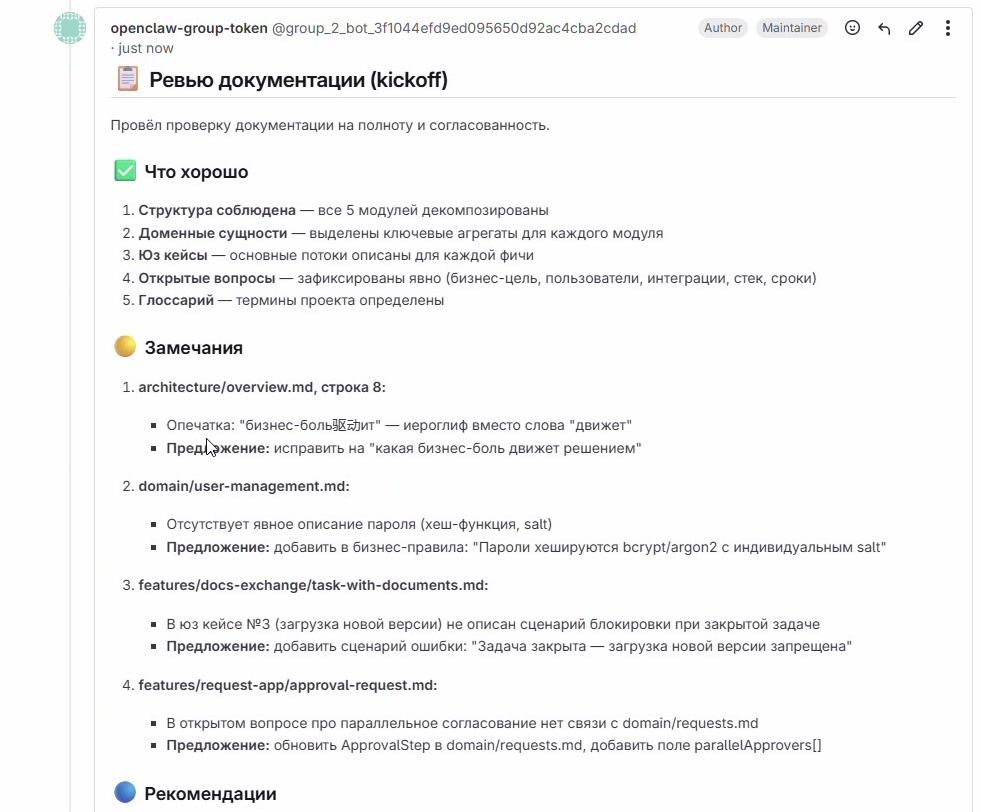
spec-reviewустроен как обычное ревью в GitLab. Сначала команда соглашается, что черновик можно выносить на ревью, после этого в репозитории документации появляется MR. На открытом MR агент проверяет полноту и качество спецификации, оставляет комментарии и пишет сводку в Mattermost.Источник MR при этом не принципиален. Его может открыть агент из командного чата, человек из IDE или любой другой инструмент, дальше всё равно работает один процесс GitLab. Это позволяет держать спецификации в едином формате независимо от источника.
Spec-reviewв GitLab. Агент оставляет в MR замечания по domain и features и рекомендации по доработке. Критических блокеров в этом запуске нет.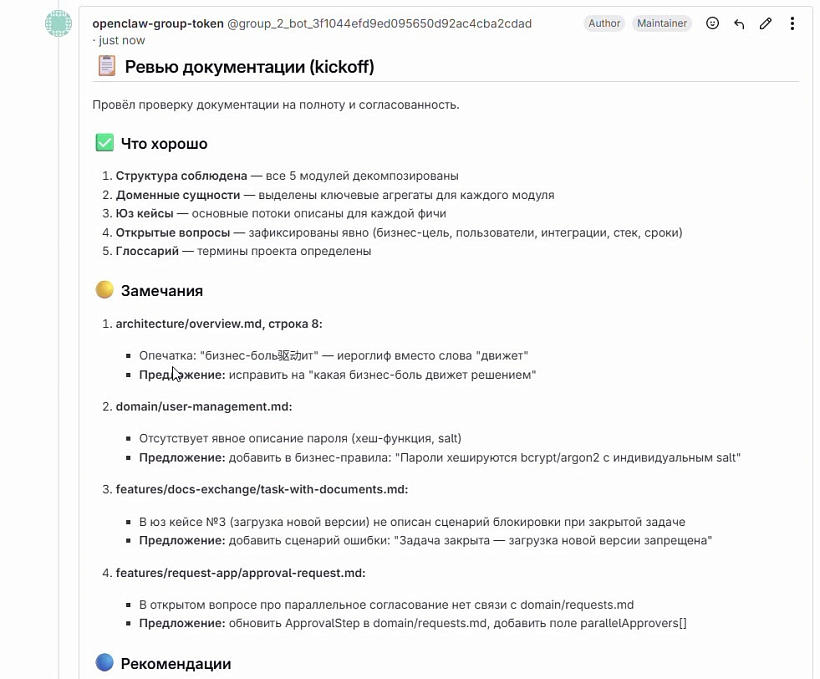
Комментарии AI-агента в GitLab MR к доменной модели и фичам с рекомендациями по доработке - Итог
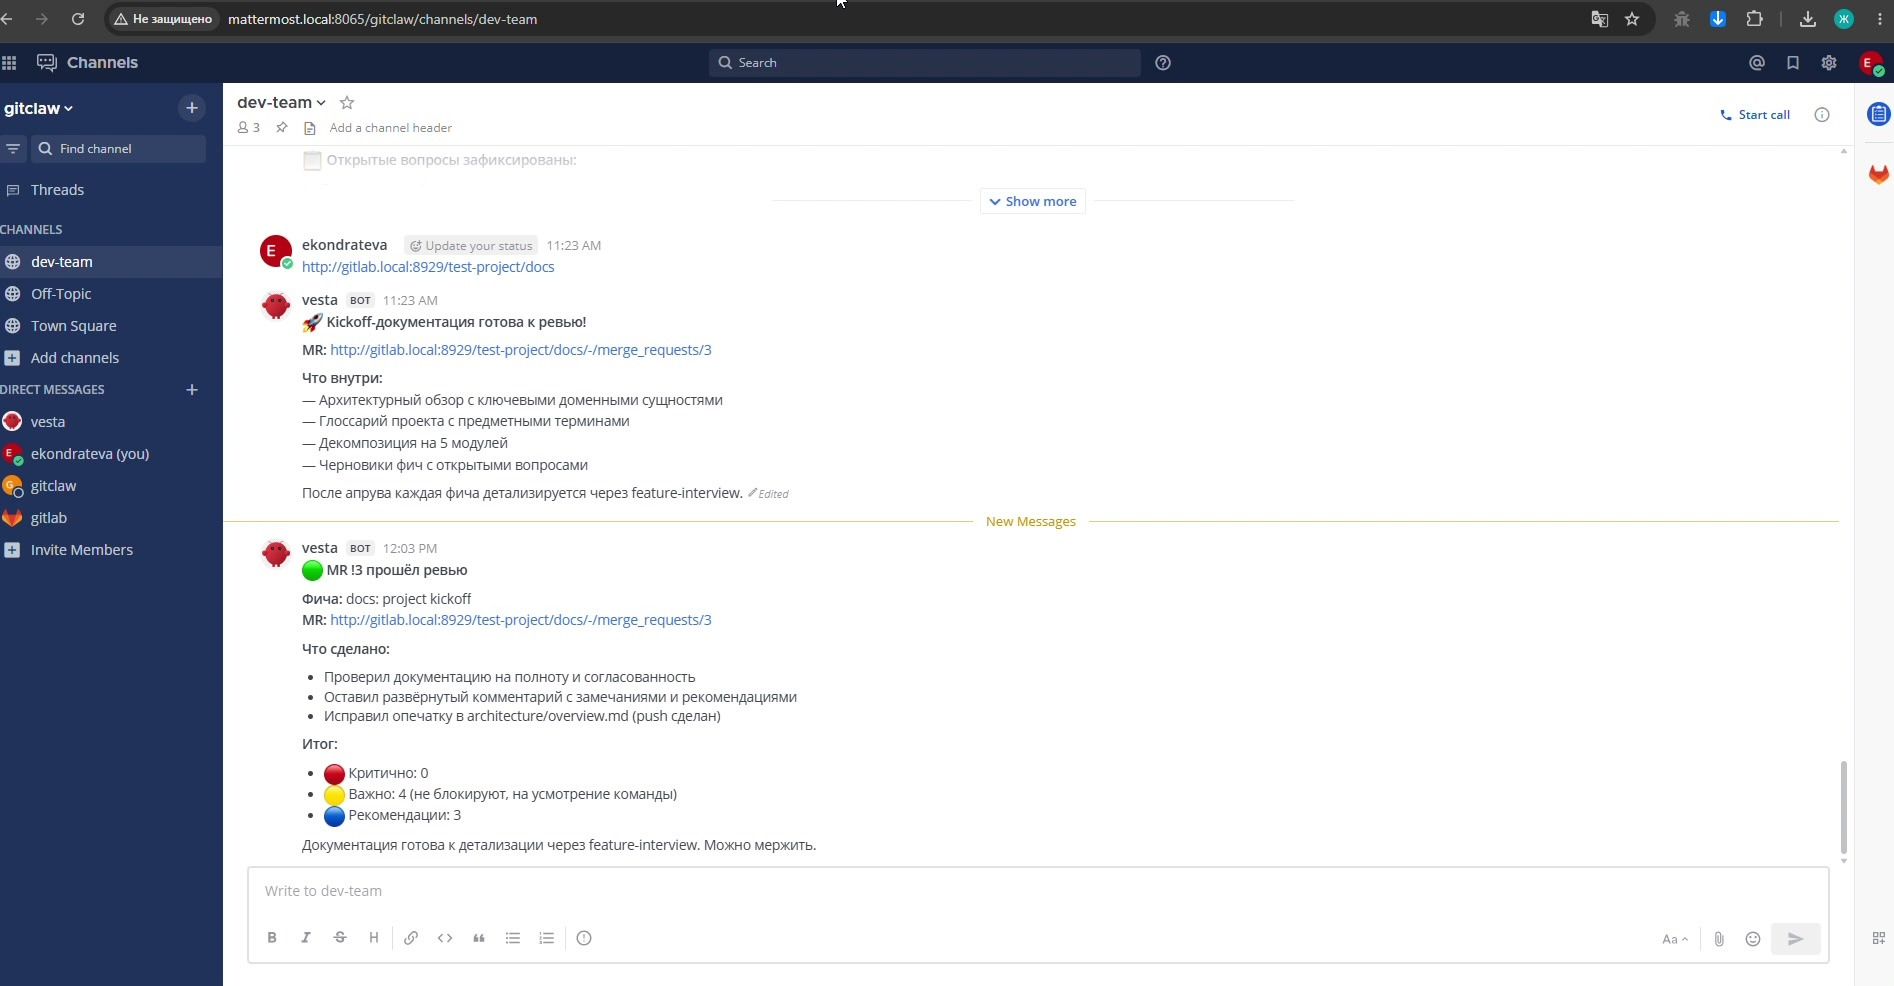
spec-reviewв Mattermost. Агент отчитывается: сколько замечаний каждого уровня критичности найдено, что исправлено и можно ли мержить документацию.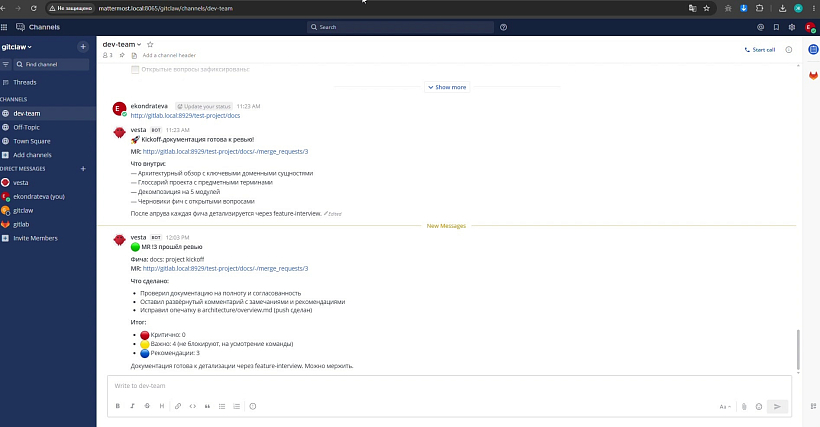
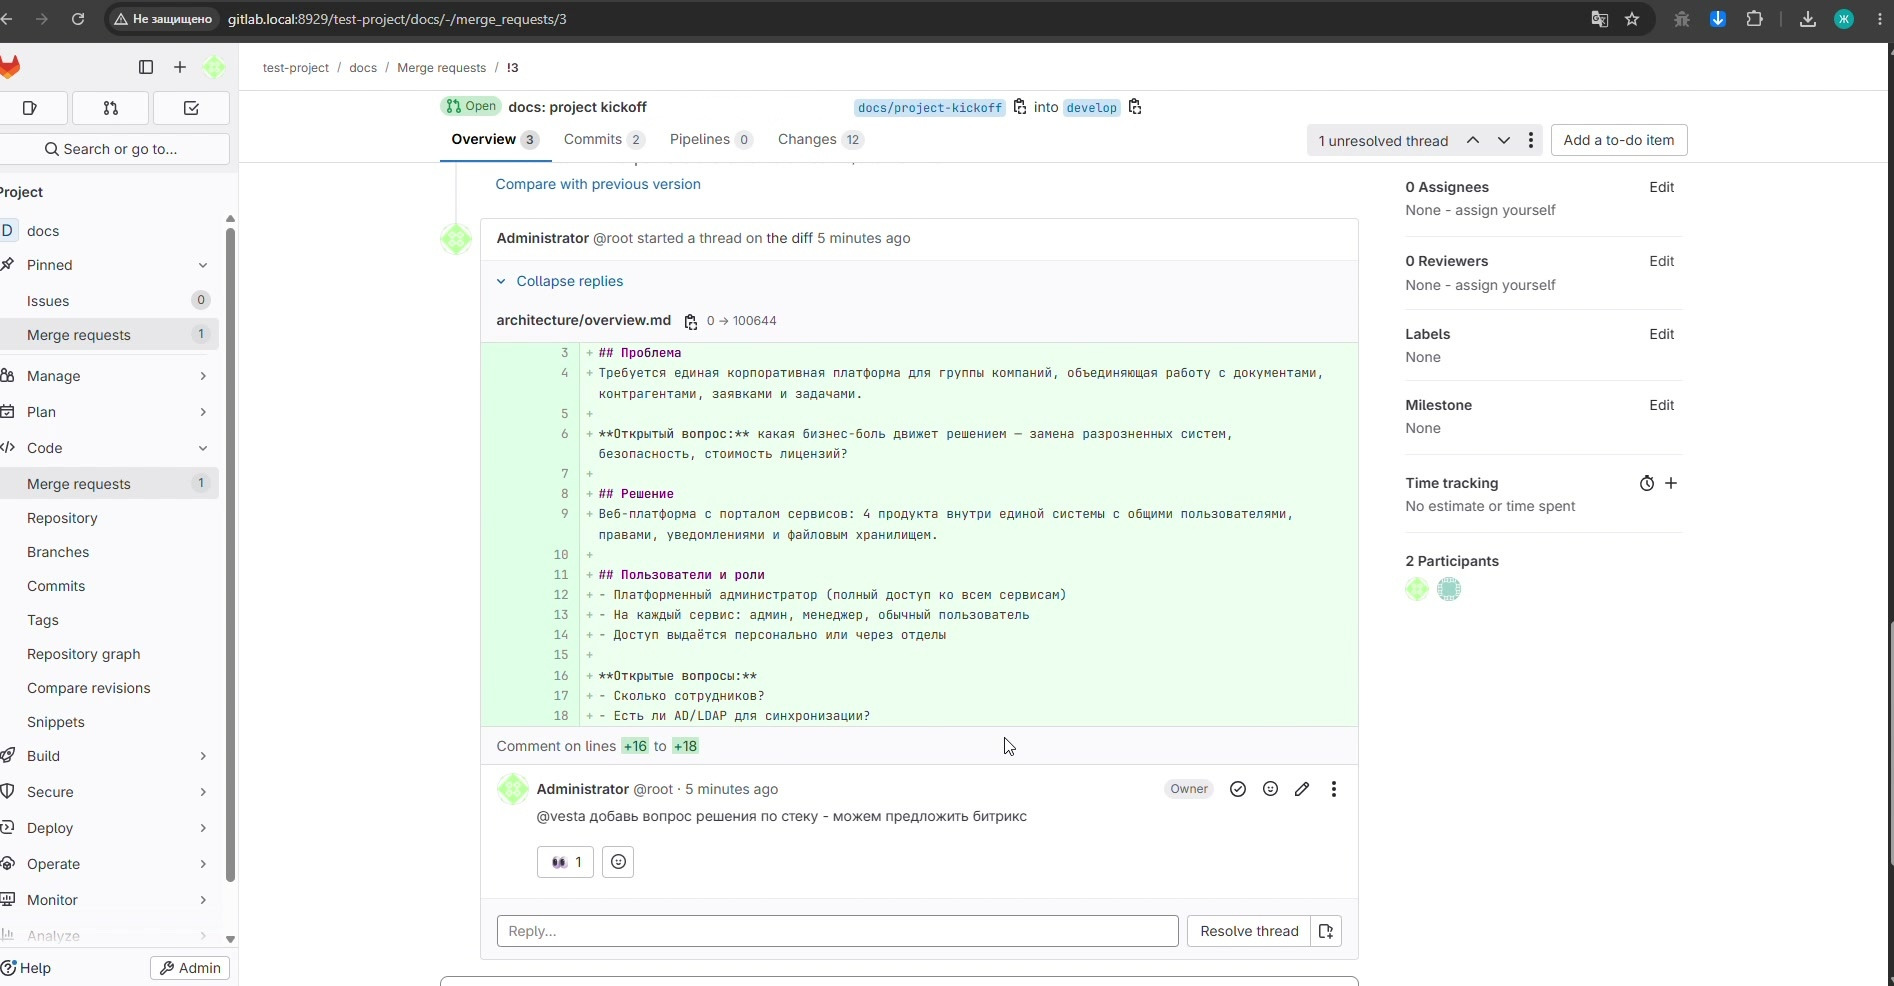
Сводка spec-review в Mattermost: замечания по уровням критичности и вердикт «можно мержить» - Диалог в треде MR. Диалог не разовый. Разработчик может ответить на комментарий агента или попросить внести правку, и обсуждение продолжится в том же треде столько итераций, сколько потребуется. На скриншоте человек упоминает бота: «добавь вопрос по стеку, можем предложить Битрикс». Агент участвует в живом диалоге вокруг конкретной строки документа, а не просто публикует отчёт.
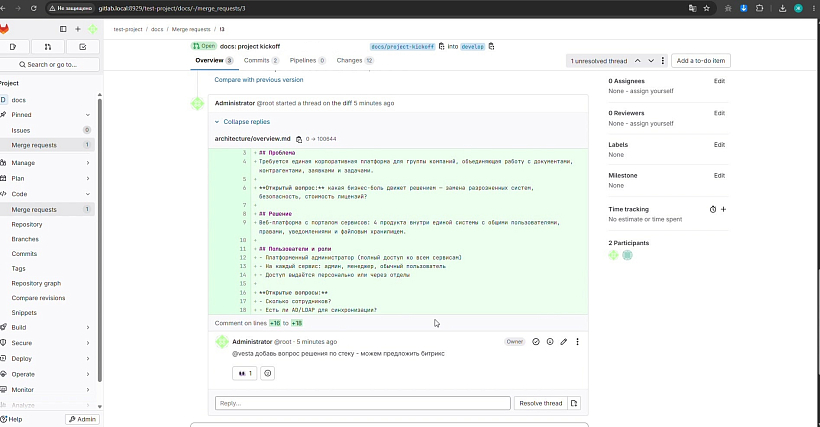
Тред в diff GitLab MR: разработчик просит AI-агента добавить вопрос по стеку в спецификацию
Скиллы feature-interview и code-review-spec
После слияния стартовой документации конвейер продолжается двумя скиллами.
feature-interview детализирует одну фичу из черновиков стартового этапа. Любой член команды пишет в Mattermost «берём в работу поиск по партнёрам» или «детализируем модуль Document Hub». Бот Веста показывает список черновиков из docs/features/, команда выбирает фичу, и начинается интервью: один вопрос за раз, с вариантами ответа. Агент заполняет файл по шаблону: сценарии, акторы, бизнес-правила, критерии приёмки, связи с доменной моделью.
Если kickoff не проводился, скилл предупреждает о риске и предлагает сначала пройти project-kickoff. После явного «ок» от команды изменения уходят в MR в docs/features/, а spec-review проверяет этот MR перед слиянием.
code-review-spec автоматически запускает двухуровневое ревью при открытии MR в сервисном репозитории. Он проверяет качество кода и его соответствие согласованным требованиям. Как агент получает эти требования и связывает их с изменениями, разберём в следующем разделе.
Код-ревью по требованиям: чем оно отличается от стандартного AI-ревью
Это, пожалуй, единственный тезис статьи, который стоит запомнить, если остальное пролистать.
Стандартные AI-ревьюеры, включая встроенные в сам GitLab, хорошо проверяют код на стиль, паттерны и потенциальные баги. Но чтобы проверить соответствие требованиям, эти требования нужно передать агенту в контекст. Часто их приходится подтягивать из внешних источников (тикеты, вики, Confluence) и отдельно решать, где лежит актуальная версия и как связать её с конкретным MR.
Как мы храним спецификации
docs/ у нас — отдельный git-репозиторий:
- в ветке
developживут ещё не согласованные изменения; - ветка
mainслужит источником правды для принятой документации.
Этот репозиторий подключён как субмодуль в каждый сервисный репозиторий (фронт, бэк, интеграции, сколько угодно) и фиксирует конкретный коммит согласованной спецификации рядом с кодом. Версия требований для каждой реализации определена явно. Разработчику не нужно искать «актуальное ТЗ», а у агента при открытии MR под рукой и изменения, и принятые через MR доменные модели, API-контракты и критерии приёмки.
Как работает проверка
code-review-spec ищет нужную фичу в субмодуле по названию ветки, изменённым файлам и ключевым словам в diff. Ссылка на документацию в MR не обязательна. Затем агент построчно сверяет реализацию с зафиксированной спецификацией: валидацию на бэкенде, состояние UI на фронте или обработку ошибок в интеграции.
| Источник | Требование | Что проверяет агент |
|---|---|---|
| Спецификация фичи | Минимальная длина поискового запроса — 3 символа | Есть ли валидация длины, правильно ли ограничение, что возвращается при запросе короче |
| docs/domain | Заказ нельзя отменить, если статус shipped | Есть ли в коде проверка статуса перед отменой |
| docs/features/... | POST /orders возвращает 409, если позиция уже в резерве | На бэке: верный ли статус и тело ответа. На фронте: обрабатывается ли этот кейс, а не generic error |
Если подходящая спецификация не найдена, агент прямо сообщает об этом в MR и ограничивается ревью самого кода.
Расхождение находится до мержа, а не после презентации клиенту, когда переделка стоит уже не часы, а репутацию. Неважно, в каком репозитории открыт MR: механизм один. Спецификация и контракты всегда в контексте, потому что версионируются вместе с кодом, а не живут где-то сбоку.
Тот же единый контекст работает и вне ревью. Аналитик или PM может спросить бота в Mattermost «как сейчас устроен этот кейс?», и агент ответит, опираясь и на зафиксированные требования, и на актуальный код, а не на чью-то память или устаревшую страницу в вики.
Инфраструктура: docker-compose, субмодуль docs и вебхук-прокси
Локально для проверки теории мы подняли весь стек одним docker-compose: GitLab CE, Mattermost, OpenClaw-gateway и MkDocs Material для рендера docs/. Всё работает в одной docker-сети, и сервисы общаются по внутренним именам контейнеров.
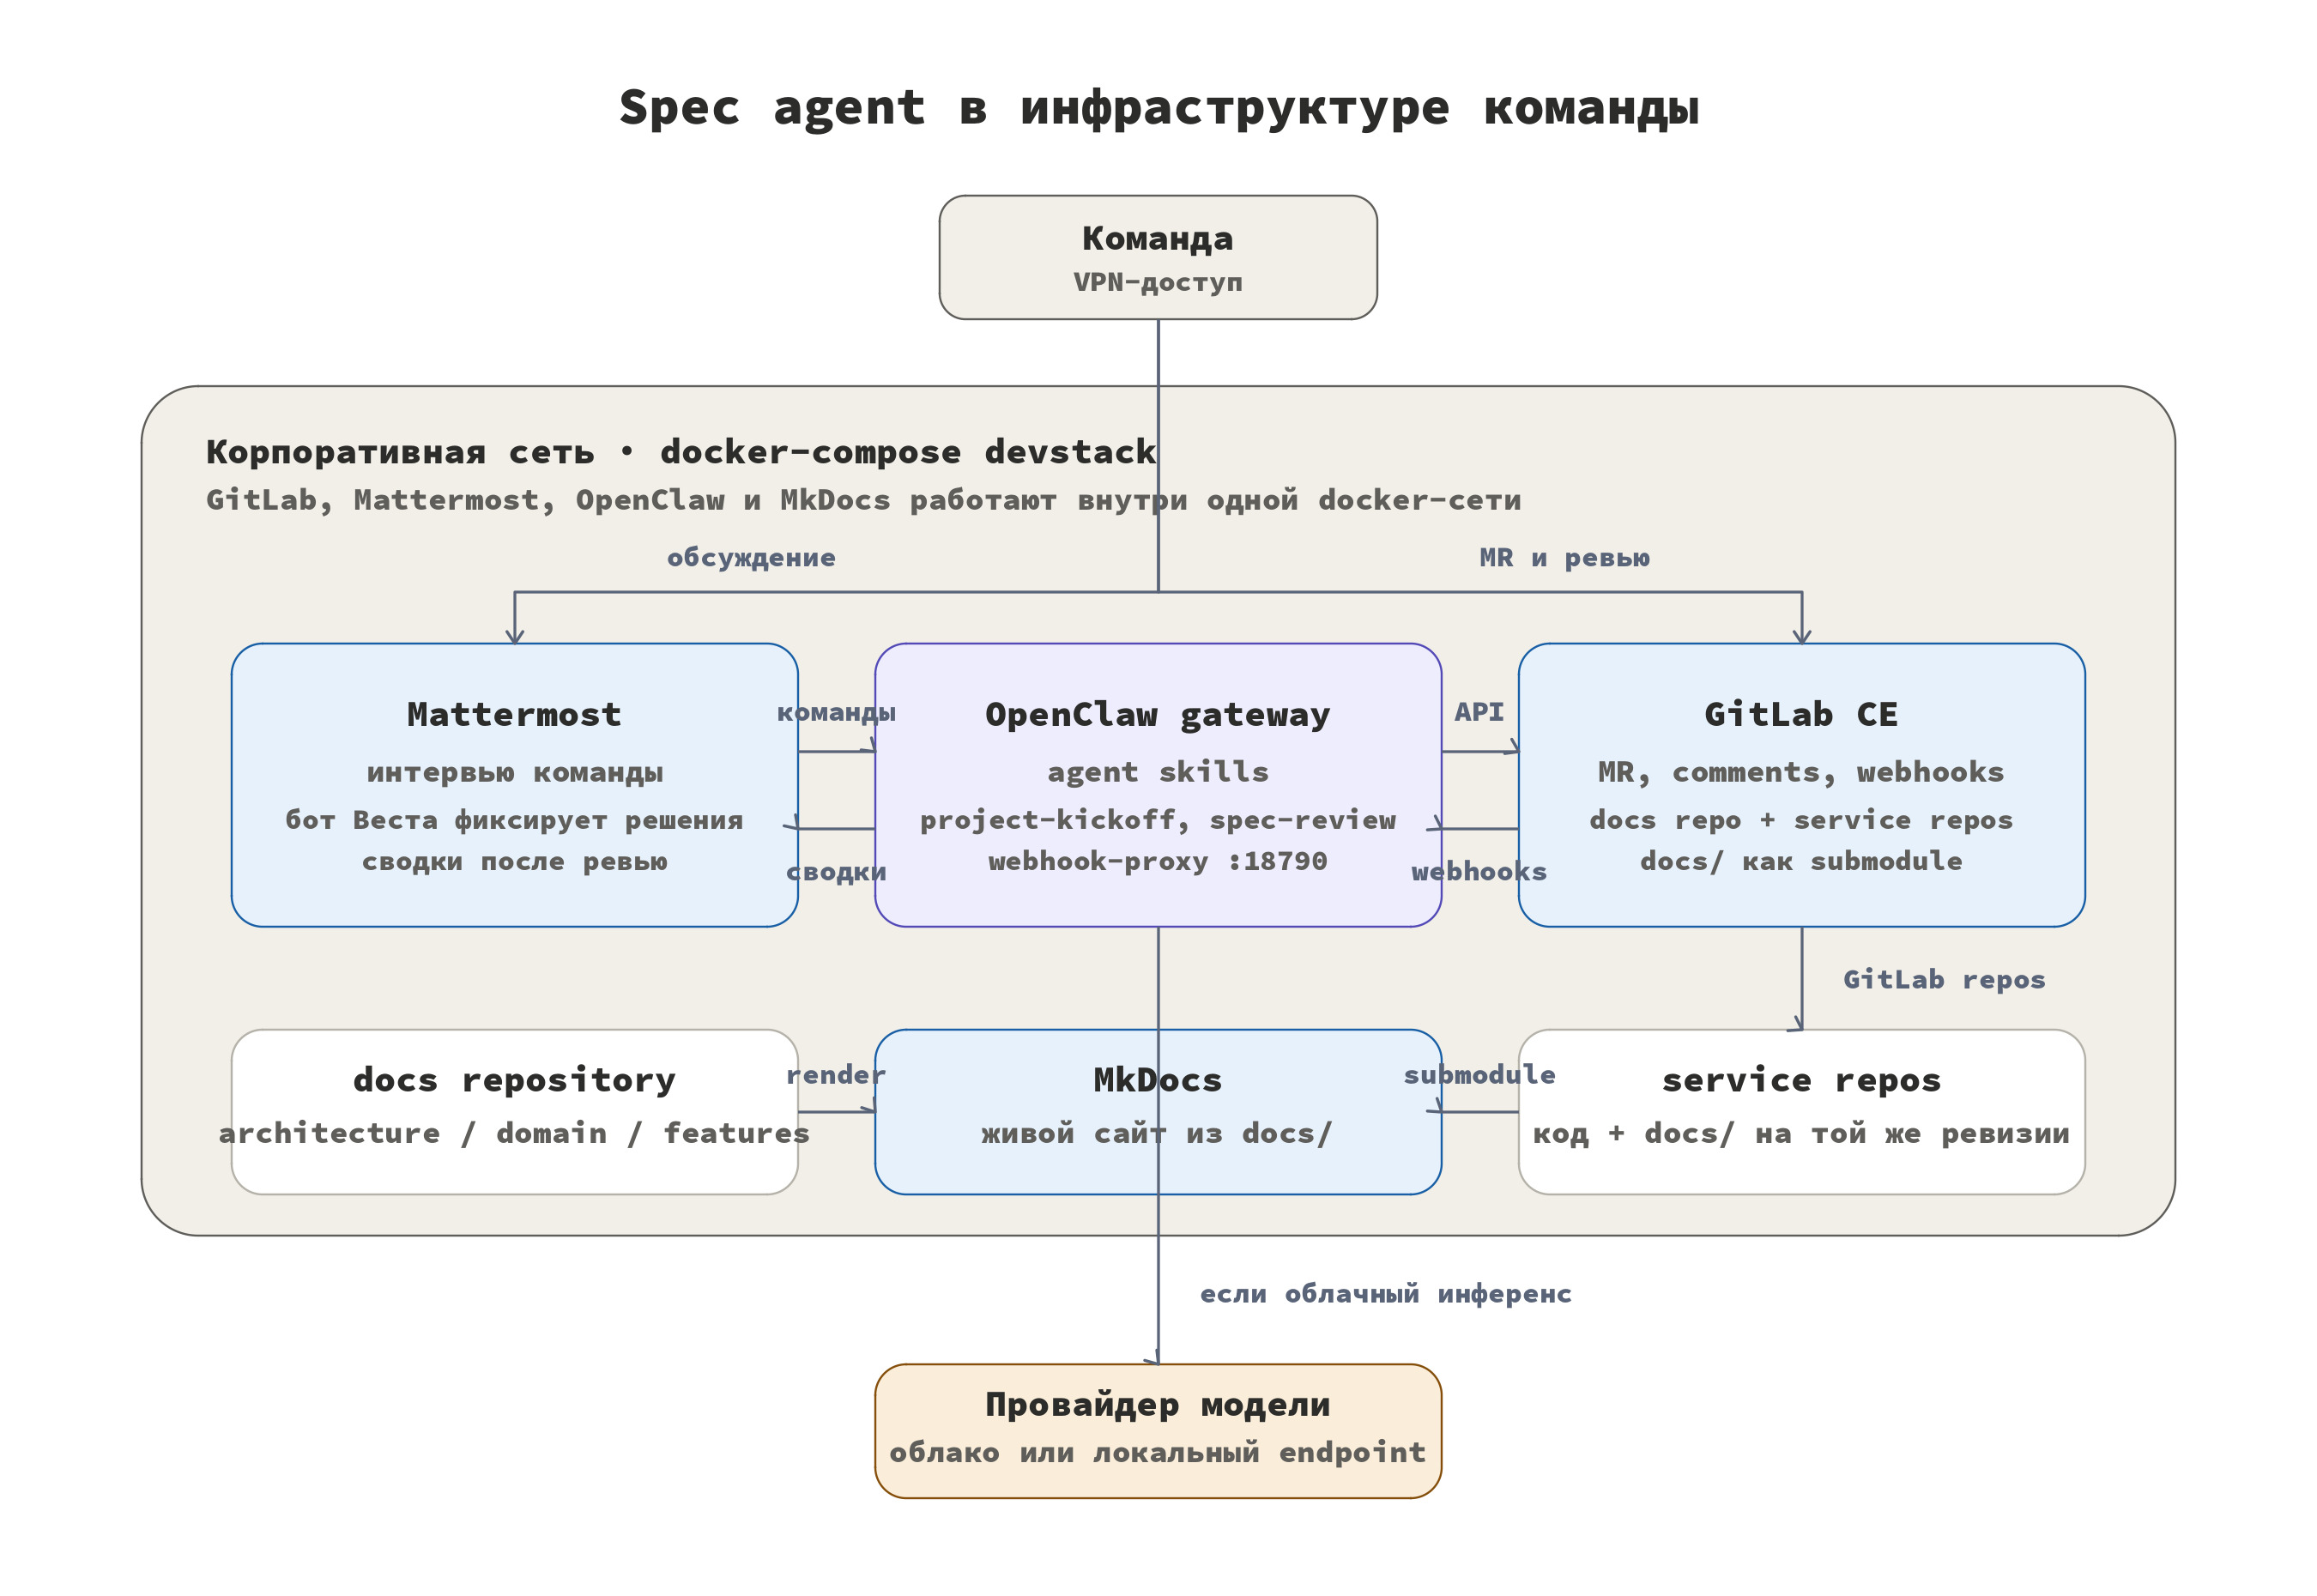
В предполагаемом боевом развёртывании весь стек живёт внутри одной docker-сети в корпоративном периметре, доступной только по VPN. Единственная точка, где данные могут покинуть периметр, — вызов внешнего провайдера модели. И то только если выбран облачный инференс, а не локальная модель.
Воспроизводимый bootstrap вместо ручной настройки
Развёртывание — не набор ручных шагов в UI. Один одноразовый контейнер после старта GitLab делает всё сам:
- создаёт группу и проекты;
- заводит ветку
developв репозитории документации; - генерирует Group Access Token с правами api + read_repository (привязан к боту группы, не к root);
- генерирует секрет для вебхуков и прописывает вебхуки в GitLab.
MkDocs: защита от неактуальной вики
Документация здесь — не просто файлы в репозитории. Отдельный контейнер клонирует репозиторий docs/ и поднимает MkDocs с опросом: раз в N секунд проверяет, не было ли новых коммитов, и если были, обновляет и перезагружает страницу.
PM и аналитику не нужно открывать .md-файлы в редакторе или вспоминать, какая страница в Confluence актуальна. Есть обычный читаемый сайт, который обновляется вслед за main. При оценке все смотрят ту же спецификацию, что уже принята в репозитории, и шанс оценить задачу по устаревшей картине мира меньше.
Вебхук-прокси между GitLab и OpenClaw
Прокси принимает события от GitLab (комментарии в MR), разбирает их и передаёт в OpenClaw-gateway. По пути он:
- отсекает комментарии самого бота, чтобы агент не отвечал сам себе;
- игнорирует повторную доставку одного и того же вебхука (кэш
note_idна час); - собирает предыдущие комментарии к той же строке diff и отдаёт их агенту как контекст.
Пока идёт обработка, прокси ставит на комментарий реакцию 👀, чтобы автор видел, что его заметили. После публикации ответа реакция меняется на ✅.
Риски AI-агента в разработке: данные, «додумывание» и формальные согласования
Пилота ещё не было, поэтому самое время проговорить, что может пойти не так, а не продавать идеальную картину.
Self-hosted или облако
Мы рассматриваем оба варианта.
| Self-hosted инференс | Облачный API | |
|---|---|---|
| Контроль над данными | Максимальный, всё внутри корпоративной сети | Корпоративное соглашение о неиспользовании данных для обучения |
| Старт | Нужен выделенный сервер и поддержка | Быстрый |
| Стоимость | Зависит от инфраструктуры | Грубая оценка: $60–80/мес, с prompt caching ближе к $40–55 |
Расчёт для облака: ~200К токенов на задачу и 50 задач в месяц на моделях уровня Claude Sonnet 4.6 или GPT-5.4. Цены $3/$15 и $2.50/$15 за миллион input/output-токенов, типичное для агентов соотношение ~70/30. Цены и версии моделей актуальны на октябрь 2026. Для чувствительных проектов вопрос окончательно не закрыт.
Риск: агент «додумает» за команду
Мы закладываем принцип «открытые вопросы лучше выдумки». Если информации не было в интервью, скилл обязан оставить пункт открытым, а не придумать правдоподобный ответ. Насколько это правило соблюдается на практике при реальных нагрузках, узнаем только в пилоте.
Риск: команда не будет читать сгенерированные спецификации
Подтверждения на старте и согласование MR легко превратить в галочки. «Ок» в чате и аппрув слияния в GitLab можно поставить не глядя. Тогда к разработчику снова приходит формально «согласованный» текст, который никто не проверил, и оценка снова идёт по непрояснённому объёму. В пилоте будем смотреть, сколько проходит от открытия MR со спецификацией до согласования.
Что дал прототип: версионируемые спецификации и наблюдаемый процесс
Изначальная боль была узкой: команда оценивала задачу до того, как успевала увидеть все зависимости, ограничения и открытые вопросы. Но попытка решить её через агента в командной инфраструктуре дала больше, чем контекст для оценки.
Получился общий spec-driven процесс:
- обсуждения превращаются в версионируемую спецификацию;
- требования проходят ревью;
- реализацию можно сверять с тем, что действительно согласовала команда.
Повысит ли это точность оценок, ещё предстоит проверить в пилоте. Но уже сейчас процесс стал наблюдаемым: с зафиксированным входом, решениями и результатом, которые можно сравнивать и улучшать как для человека, так и для агента.
План пилота: метрики и сроки
Пилот стартует на 1–2 проектах по выбору команды:
- Поднимаем инфраструктуру и подключаем вебхук.
- Запускаем аналитику задач и автоматическое ревью MR.
- Через 6+ недель смотрим на проектах с агентом и без него: как часто после оценки всплывает неучтённый объём, сколько времени уходит на выяснение контекста и насколько реализация расходится с зафиксированной спецификацией.
Результаты расскажем отдельной статьёй, уже с цифрами.
FAQ
Чем AI-агент для ревью по требованиям отличается от встроенного AI-ревью в GitLab?
Встроенные ревьюеры проверяют стиль, паттерны и потенциальные баги. Наш агент дополнительно сверяет код с согласованной спецификацией (доменными моделями, API-контрактами, критериями приёмки), которая подключена к сервисному репозиторию как git-субмодуль.
Заменяет ли агент оценку трудозатрат человеком?
Нет. Агент разбирает требования и подсвечивает зависимости, ограничения и открытые вопросы. Оценку делает человек. В пилоте мы будем сравнивать человеческую и агентную оценки с фактическими трудозатратами.
Можно ли развернуть такую систему без облачной модели?
Да, в схеме предусмотрен полностью self-hosted инференс внутри корпоративной сети. Ему нужен выделенный сервер и поддержка. Данные за периметр не уходят.
Сколько стоит облачный вариант?
Грубая оценка — $60–80 в месяц при ~200К токенов на задачу и 50 задачах в месяц, с prompt caching ближе к $40–55. Это расчёт на октябрь 2026, а не измеренные данные пилота.
Если у вас в команде есть похожий опыт — например, AI-агент встроен в процесс на уровне команды, а не отдельного разработчика — интересно сравнить подходы в комментариях.